להורדה | SparkMoE גרסה V0.4.2 - הרצת מודלי שפה גדולים על חומרה חלשה! עדכון י"א תשרי תשפ"ז
-
שחררתי בגיטהאב את הגרסה החדשה של התוכנה שלי - SparkMoE.
למי שעדיין לא מכיר מהגרסה הקודמת, מדובר בתוכנה מהפכנית שמאפשרת להריץ מודלי AI גדולים בארכיטקטורת MoE על חומרה חלשה מאוד, באמצעות טעינת מומחים לדיסק במקום ל-RAM.
לדוגמה, על החומרה שלי - 16 RAM בלבד ללא GPU, אני מקבל עם SparkMoE 5-7 טוקנים לשנייה במודלים כמו Qwen 3.6 35B ו-Gemma 4 26B.
הצלחתי אפילו להריץ באופן מקומי לחלוטין את Qwen 3.8 Flash Next - מודל של 181B, ברמת Gemini 3.8 Flash, עם 0.5 טוק' לשנייה.בין השיפורים:
- SparkMoE קיבלה חלון עצמאי, במקום לפתוח 2 כרטיסיות בדפדפן + חלון CMD.
- ה-UI של SparkMoE אוחד במלואו עם ה-UI המקורי של llama.cpp, כך שאין יותר שני מסכים נפרדים לניהול SparkMoE ולניהול llama.cpp, אלא הכל נמצא תחת אותו ממשק.
- שיפורים משמעותיים בהאצת מהירות הסקת המודלים.
- הוספת תמיכה בארכיטקטורת
qwen4exp- עבור Qwen 3.8 Flash Next (שמקבל כ-0.5 טוק' לשנייה על מחשב פשוט עם 16 RAM עם SparkMoE), ומשפחת מודלי Qwen 4 שתשוחרר בקרוב. - הוספת תמיכה בטבלאות
n-gramוטעינתם לדיסק במקום ל-RAM - רלוונטי במיוחד עבור Qwen 3.8 Flash Next ומשפחת מודלי Qwen 4 העתידיים. - ניהול נוח יותר של כלל ההגדרות, כולל הגדרה פר מודל.
- שיפורים רבים נוספים.
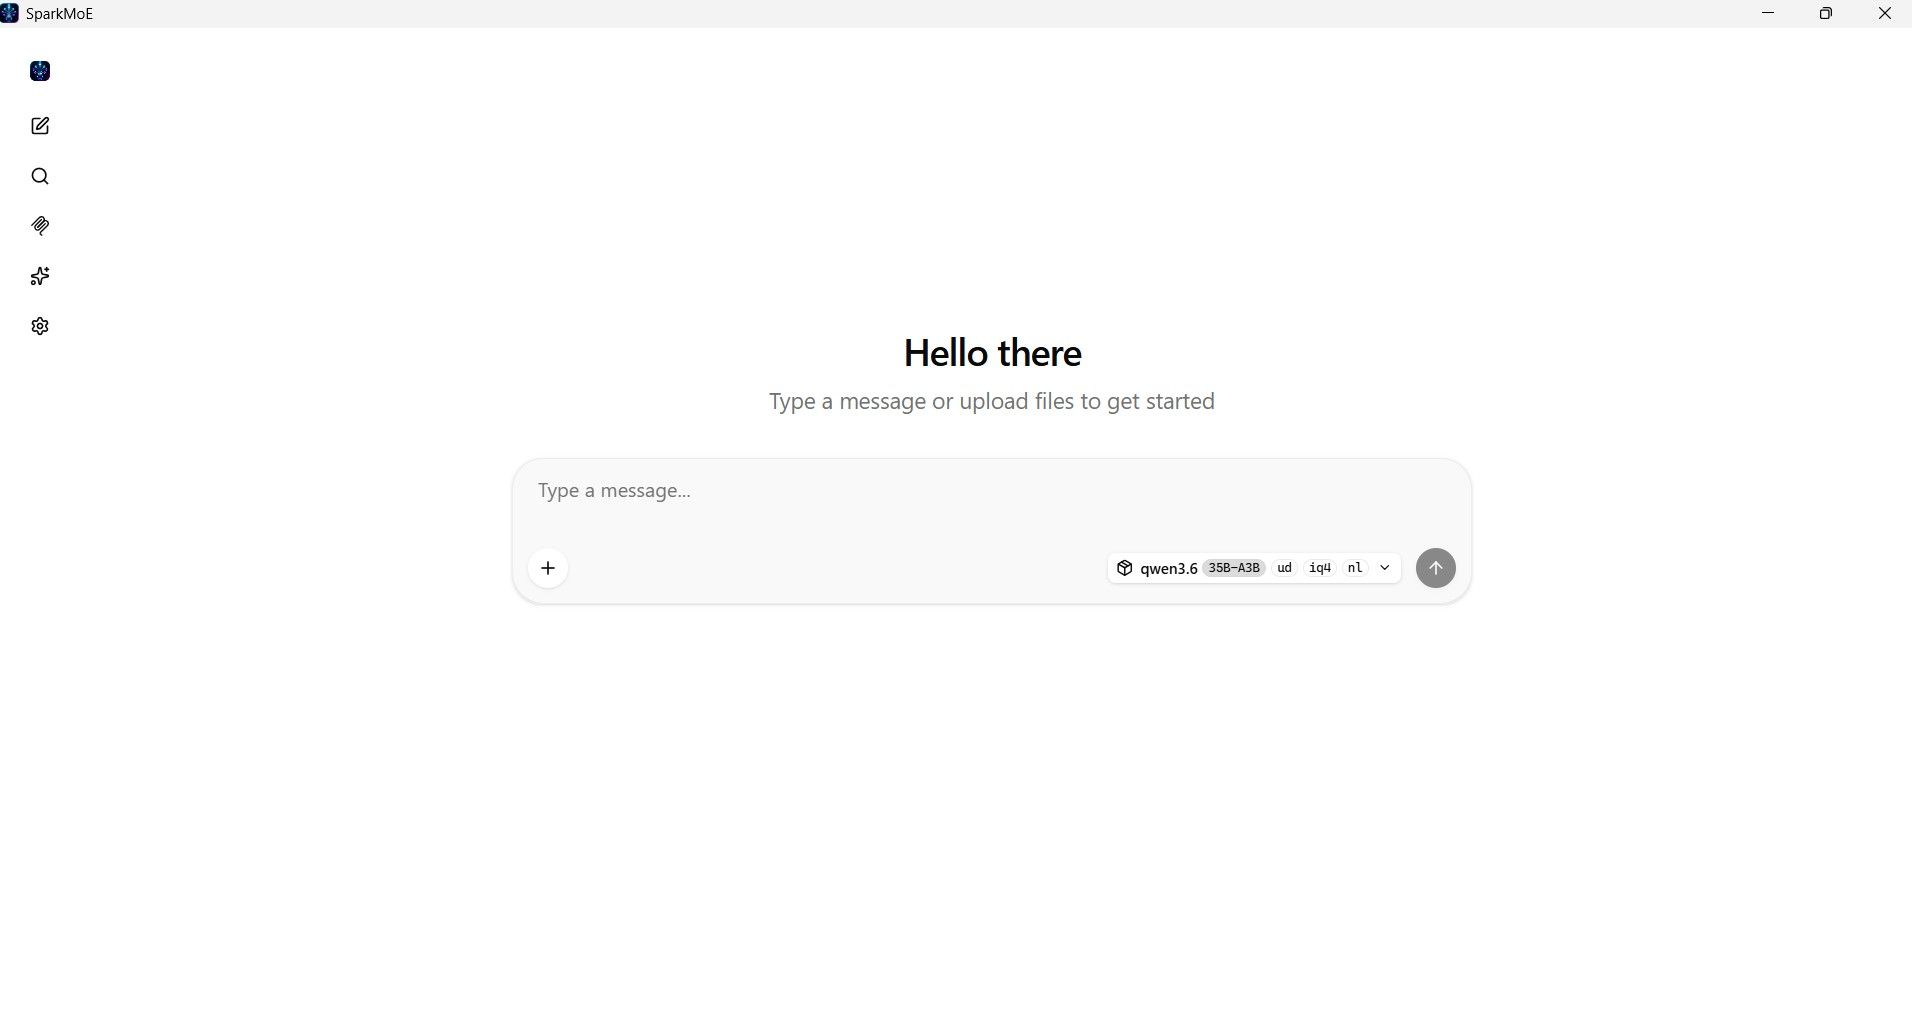
תמונות לדוגמה:
- ממשק הצ'אט:
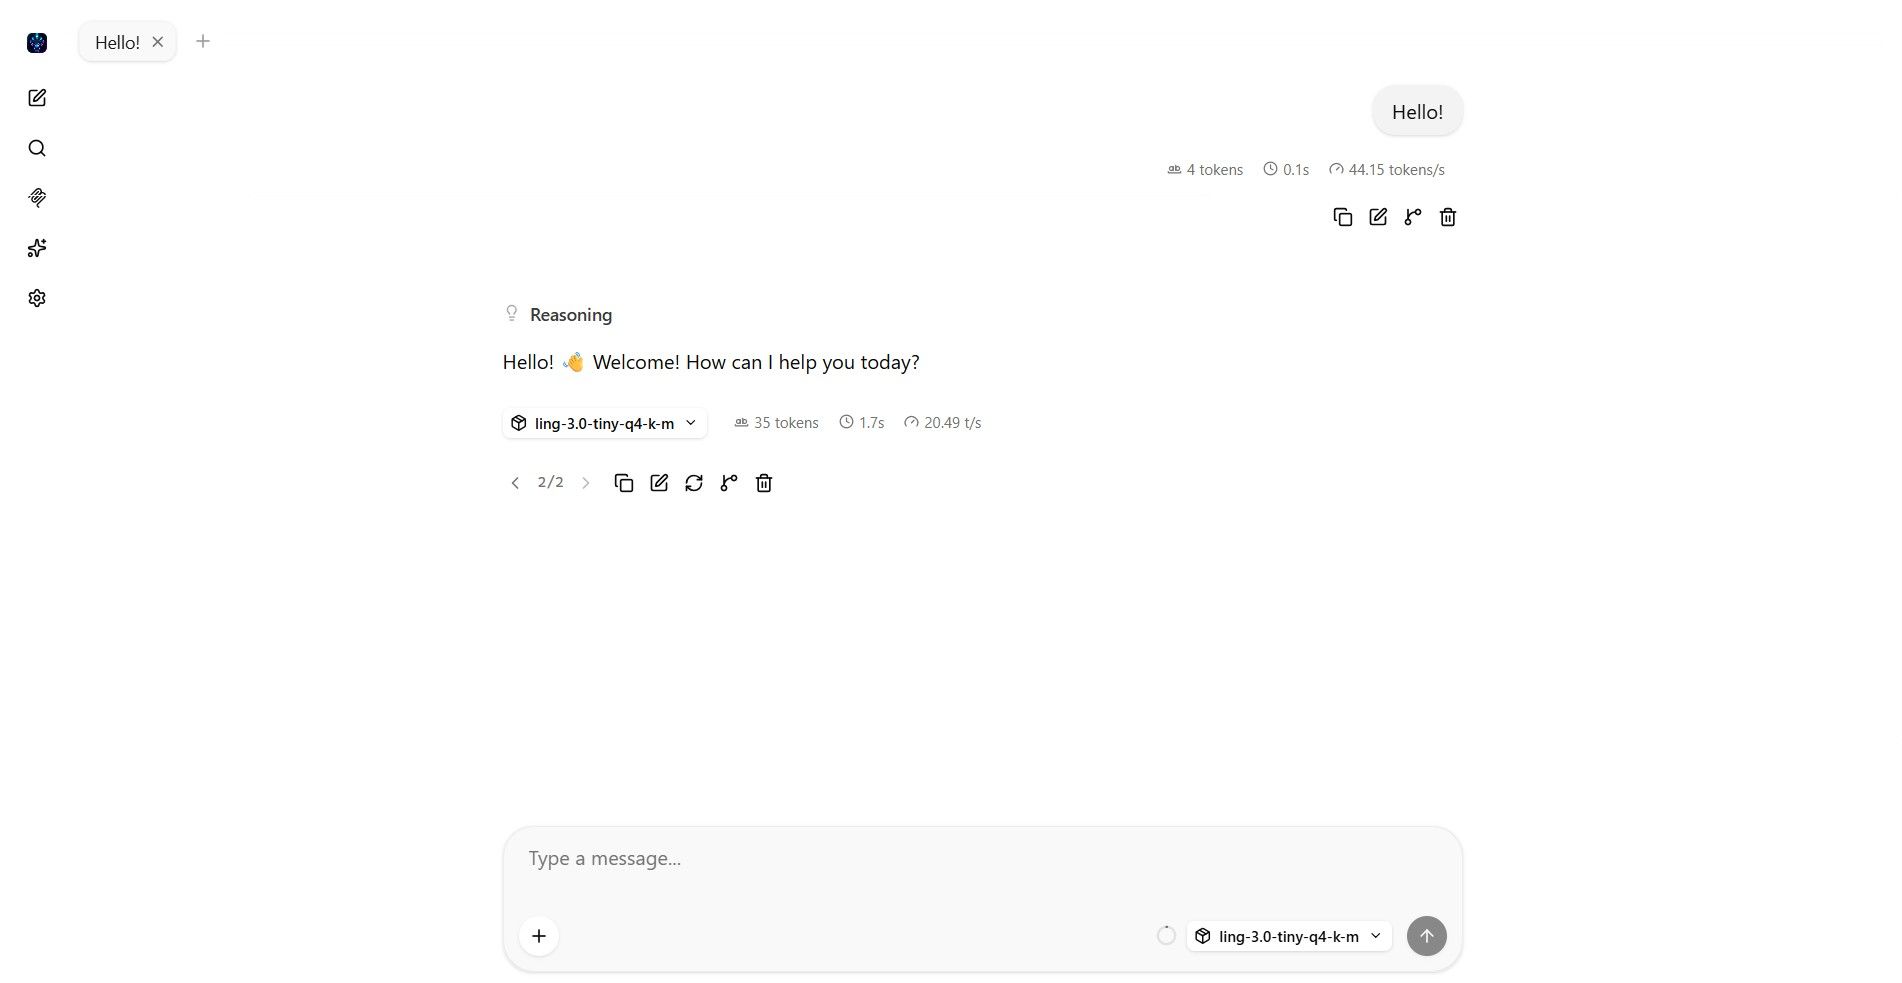
- ממשק ניהול SparkMoE:
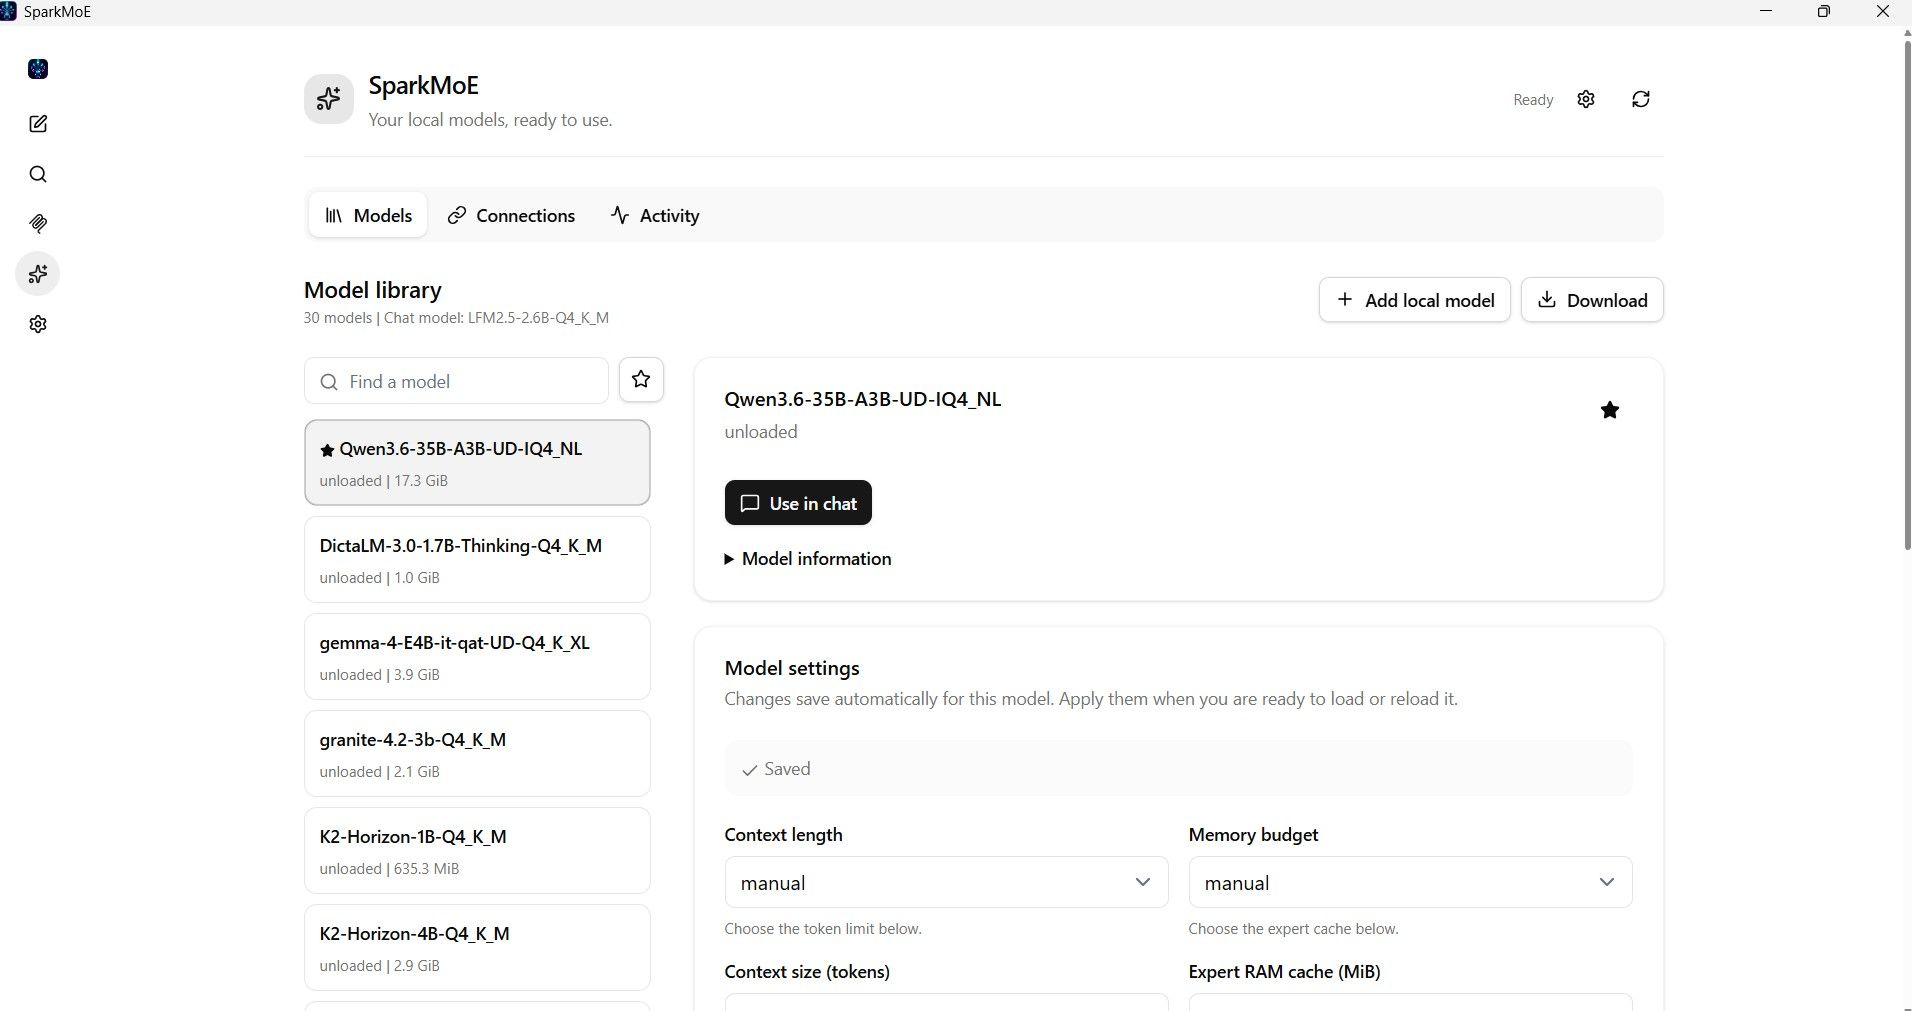
הורדה:
הפרוייקט זמין בקוד פתוח בגיטהאב, ראו כאן.
ניתן להוריד קובץ EXE להתקנה מהירה מה-releases, או גרסת ZIP ניידת (לחלץ לתיקיה ולהפעיל את SparkMoE.exe).
אל תשכחו לשים במאגר בגיטהאב על הדרך!
(הקוד המקורי של llama.cpp ברישיון MIT, והחלקים שלי תחת רישיון לא מסחרי).
אשמח לקבל משוב, הערות והארות על SparkMoE!
-
שחררתי בגיטהאב את הגרסה החדשה של התוכנה שלי - SparkMoE.
למי שעדיין לא מכיר מהגרסה הקודמת, מדובר בתוכנה מהפכנית שמאפשרת להריץ מודלי AI גדולים בארכיטקטורת MoE על חומרה חלשה מאוד, באמצעות טעינת מומחים לדיסק במקום ל-RAM.
לדוגמה, על החומרה שלי - 16 RAM בלבד ללא GPU, אני מקבל עם SparkMoE 5-7 טוקנים לשנייה במודלים כמו Qwen 3.6 35B ו-Gemma 4 26B.
הצלחתי אפילו להריץ באופן מקומי לחלוטין את Qwen 3.8 Flash Next - מודל של 181B, ברמת Gemini 3.8 Flash, עם 0.5 טוק' לשנייה.בין השיפורים:
- SparkMoE קיבלה חלון עצמאי, במקום לפתוח 2 כרטיסיות בדפדפן + חלון CMD.
- ה-UI של SparkMoE אוחד במלואו עם ה-UI המקורי של llama.cpp, כך שאין יותר שני מסכים נפרדים לניהול SparkMoE ולניהול llama.cpp, אלא הכל נמצא תחת אותו ממשק.
- שיפורים משמעותיים בהאצת מהירות הסקת המודלים.
- הוספת תמיכה בארכיטקטורת
qwen4exp- עבור Qwen 3.8 Flash Next (שמקבל כ-0.5 טוק' לשנייה על מחשב פשוט עם 16 RAM עם SparkMoE), ומשפחת מודלי Qwen 4 שתשוחרר בקרוב. - הוספת תמיכה בטבלאות
n-gramוטעינתם לדיסק במקום ל-RAM - רלוונטי במיוחד עבור Qwen 3.8 Flash Next ומשפחת מודלי Qwen 4 העתידיים. - ניהול נוח יותר של כלל ההגדרות, כולל הגדרה פר מודל.
- שיפורים רבים נוספים.
תמונות לדוגמה:
- ממשק הצ'אט:
- ממשק ניהול SparkMoE:
הורדה:
הפרוייקט זמין בקוד פתוח בגיטהאב, ראו כאן.
ניתן להוריד קובץ EXE להתקנה מהירה מה-releases, או גרסת ZIP ניידת (לחלץ לתיקיה ולהפעיל את SparkMoE.exe).
אל תשכחו לשים במאגר בגיטהאב על הדרך!
(הקוד המקורי של llama.cpp ברישיון MIT, והחלקים שלי תחת רישיון לא מסחרי).
אשמח לקבל משוב, הערות והארות על SparkMoE!
-
@א.מ.ד. זה בעצם ai עם אופציה לבחירת מודלים עוצמתיים?
@יודע-ומייבין זה תוכנה שמאפשרת להשתמש במודלים מקומיים גדולים יותר שבעיקרון לא מתאימים לחומרה ביתית.
רק מה - היא איטית יותר..
פרופיל גיטהאב:
https://github.com/Amlaach
אתר (סתם בשביל הכיף) - https://amlaach.github.io/personal-site/ -
@יודע-ומייבין זה תוכנה שמאפשרת להשתמש במודלים מקומיים גדולים יותר שבעיקרון לא מתאימים לחומרה ביתית.
רק מה - היא איטית יותר..
-
@בני-הבוט ואם הייתי מריץ עם lama.cpp היית מקבל הרבה יותר מהר
פרופיל גיטהאב:
https://github.com/Amlaach
אתר (סתם בשביל הכיף) - https://amlaach.github.io/personal-site/ -
@בני-הבוט ואם הייתי מריץ עם lama.cpp היית מקבל הרבה יותר מהר
אז ככה: כרגע המהירות במודלים רגילים זהה ואפילו שווה ל-llama.cpp הרגיל.
ואפילו במודלי MoE עם טעינת מומחים ל-SSD, הצלחתי להגיע למהירות כמו llama.cpp הרגיל. בדקתי את זה עם Ling 3.0 Tiny, שהגיע ל-20 טוק' לשנייה גם בהרצה רגילה וגם בטעינת מומחים ל-SSD. כמובן שככל שגודל המודל עולה כמות המומחים שנכנסת למטמון פוחתת כך שנוצר פער, אבל הוא לא משמעותי. -
@בני-הבוט ואם הייתי מריץ עם lama.cpp היית מקבל הרבה יותר מהר
אז ככה: כרגע המהירות במודלים רגילים זהה ואפילו שווה ל-llama.cpp הרגיל.
ואפילו במודלי MoE עם טעינת מומחים ל-SSD, הצלחתי להגיע למהירות כמו llama.cpp הרגיל. בדקתי את זה עם Ling 3.0 Tiny, שהגיע ל-20 טוק' לשנייה גם בהרצה רגילה וגם בטעינת מומחים ל-SSD. כמובן שככל שגודל המודל עולה כמות המומחים שנכנסת למטמון פוחתת כך שנוצר פער, אבל הוא לא משמעותי.@א.מ.ד. זה ממש לא נכון,
ככל שכמות הליבות קטנה יותר, או שמחזור השעון איטי יותר - המהירות תונמך.
בדיקות לא עושים על מחשב גיימינג..פרופיל גיטהאב:
https://github.com/Amlaach
אתר (סתם בשביל הכיף) - https://amlaach.github.io/personal-site/ -
@א.מ.ד. זה ממש לא נכון,
ככל שכמות הליבות קטנה יותר, או שמחזור השעון איטי יותר - המהירות תונמך.
בדיקות לא עושים על מחשב גיימינג..@א.מ.ד. זה ממש לא נכון,
ככל שכמות הליבות קטנה יותר, או שמחזור השעון איטי יותר - המהירות תונמך.מה זה קשור? אני מדבר ביחס ל-llama.cpp הרגיל.
אני אומר לך מספרים מציאותיים, לא סתם השערות.
ואגב, רוחב פס משמעותי פי כמה ממספר הליבות.בדיקות לא עושים על מחשב גיימינג..
לי יש מחשב גיימינג? הלוואי... 16 RAM ללא GPU ועם 8 ליבות...
-
@א.מ.ד. זה ממש לא נכון,
ככל שכמות הליבות קטנה יותר, או שמחזור השעון איטי יותר - המהירות תונמך.מה זה קשור? אני מדבר ביחס ל-llama.cpp הרגיל.
אני אומר לך מספרים מציאותיים, לא סתם השערות.
ואגב, רוחב פס משמעותי פי כמה ממספר הליבות.בדיקות לא עושים על מחשב גיימינג..
לי יש מחשב גיימינג? הלוואי... 16 RAM ללא GPU ועם 8 ליבות...
מה זה קשור? אני מדבר ביחס ל-llama.cpp הרגיל.
אני אומר לך מספרים מציאותיים, לא סתם השערות.נכון מאוד, ביחס לlama.cpp המהירות תונמך, וזה בגלל שלאמה מיועד להתמודד עם זה,
אני גם לא כתבתי מספרים בדווקא כדי להימנע מהשערות.ואגב, רוחב פס משמעותי פי כמה ממספר הליבות.
א׳ מניין לך?
ב׳ גם אם נניח שכן, שלך וודאי לא עוקף את לאמה בהקשר הזה, אלא מה - אין לה ייתרון על שלך.
וכן מסתכלים על איפה שכן יש ייתרון, גם אם הוא קטן משמעותית.לי יש מחשב גיימינג? הלוואי... 16 RAM ללא GPU ועם 8 ליבות...
דרך אגב, סתם סקרנות, יש לך nvme?
פרופיל גיטהאב:
https://github.com/Amlaach
אתר (סתם בשביל הכיף) - https://amlaach.github.io/personal-site/ -
מה זה קשור? אני מדבר ביחס ל-llama.cpp הרגיל.
אני אומר לך מספרים מציאותיים, לא סתם השערות.נכון מאוד, ביחס לlama.cpp המהירות תונמך, וזה בגלל שלאמה מיועד להתמודד עם זה,
אני גם לא כתבתי מספרים בדווקא כדי להימנע מהשערות.ואגב, רוחב פס משמעותי פי כמה ממספר הליבות.
א׳ מניין לך?
ב׳ גם אם נניח שכן, שלך וודאי לא עוקף את לאמה בהקשר הזה, אלא מה - אין לה ייתרון על שלך.
וכן מסתכלים על איפה שכן יש ייתרון, גם אם הוא קטן משמעותית.לי יש מחשב גיימינג? הלוואי... 16 RAM ללא GPU ועם 8 ליבות...
דרך אגב, סתם סקרנות, יש לך nvme?
נכון מאוד, ביחס לlama.cpp המהירות תונמך, וזה בגלל שלאמה מיועד להתמודד עם זה,
אני גם לא כתבתי מספרים בדווקא כדי להימנע מהשערות.אבל גם שלי מיועד להתמודד עם זה, מהסיבה הפשוטה שהתוכנה שלי היא llama.cpp עם התאמות.
א׳ מניין לך?
מציאות. תבדוק איפה שאתה רוצה. תג'פט או תגגל.
ב׳ גם אם נניח שכן, שלך וודאי לא עוקף את לאמה בהקשר הזה, אלא מה - אין לה ייתרון על שלך.
וכן מסתכלים על איפה שכן יש ייתרון, גם אם הוא קטן משמעותית.לא כתבתי ששלי עוקף, אלא זהה.
וכן, יש מצב ששלי עוקף, כי עשיתי כמה אופטימיזציות שמפתחי llama.cpp בחרו שלא לעשות במודע, כי המטרה שלי קצת שונה משלהם.ועם 8 ליבות...
תיקון טעות - יש לי 10 ליבות, אבל 8 מתוכן הן ליבות יעילות ורק 2 ליבות ביצועים.
אז אמנם יש לי 10 ליבות, אבל זה i5 חסכוני מסדרת U. מחשב גיימינג נקבע בעיקר לפי כרטיס המסך וההספק, לא לפי מספר הליבות.
מדובר במחשב שפעת ב-1700 ש"ח... -
מה זה קשור? אני מדבר ביחס ל-llama.cpp הרגיל.
אני אומר לך מספרים מציאותיים, לא סתם השערות.נכון מאוד, ביחס לlama.cpp המהירות תונמך, וזה בגלל שלאמה מיועד להתמודד עם זה,
אני גם לא כתבתי מספרים בדווקא כדי להימנע מהשערות.ואגב, רוחב פס משמעותי פי כמה ממספר הליבות.
א׳ מניין לך?
ב׳ גם אם נניח שכן, שלך וודאי לא עוקף את לאמה בהקשר הזה, אלא מה - אין לה ייתרון על שלך.
וכן מסתכלים על איפה שכן יש ייתרון, גם אם הוא קטן משמעותית.לי יש מחשב גיימינג? הלוואי... 16 RAM ללא GPU ועם 8 ליבות...
דרך אגב, סתם סקרנות, יש לך nvme?
-
נכון מאוד, ביחס לlama.cpp המהירות תונמך, וזה בגלל שלאמה מיועד להתמודד עם זה,
אני גם לא כתבתי מספרים בדווקא כדי להימנע מהשערות.אבל גם שלי מיועד להתמודד עם זה, מהסיבה הפשוטה שהתוכנה שלי היא llama.cpp עם התאמות.
א׳ מניין לך?
מציאות. תבדוק איפה שאתה רוצה. תג'פט או תגגל.
ב׳ גם אם נניח שכן, שלך וודאי לא עוקף את לאמה בהקשר הזה, אלא מה - אין לה ייתרון על שלך.
וכן מסתכלים על איפה שכן יש ייתרון, גם אם הוא קטן משמעותית.לא כתבתי ששלי עוקף, אלא זהה.
וכן, יש מצב ששלי עוקף, כי עשיתי כמה אופטימיזציות שמפתחי llama.cpp בחרו שלא לעשות במודע, כי המטרה שלי קצת שונה משלהם.ועם 8 ליבות...
תיקון טעות - יש לי 10 ליבות, אבל 8 מתוכן הן ליבות יעילות ורק 2 ליבות ביצועים.
אז אמנם יש לי 10 ליבות, אבל זה i5 חסכוני מסדרת U. מחשב גיימינג נקבע בעיקר לפי כרטיס המסך וההספק, לא לפי מספר הליבות.
מדובר במחשב שפעת ב-1700 ש"ח...הליבות ינוצלו למקסימום על ידי מערכת ההפעלה.
מה תאמר למחשב עם 4 ליבות?
כן. אבל זה הסטנדרט היום.
כמובן, סתם מסקרן אם הדרך העברה מהssd לא נפגמת ככה..
פרופיל גיטהאב:
https://github.com/Amlaach
אתר (סתם בשביל הכיף) - https://amlaach.github.io/personal-site/ -
הליבות ינוצלו למקסימום על ידי מערכת ההפעלה.
טוב, נו, זה המחשב הכי זול שהיה בחנות, אין מה להתווכח... ליבות יעילות הכוונה ליבות חלשות שנועדו להריץ תהליכים חלשים...
כמובן, סתם מסקרן אם הדרך העברה מהssd לא נפגמת ככה..
מה פירוש?
-
@א.מ.ד. הדרך שבה המומחים עוברים, לא בדקתי את זה אבל nvme זה צורה אחרת של העברת נתונים..
פרופיל גיטהאב:
https://github.com/Amlaach
אתר (סתם בשביל הכיף) - https://amlaach.github.io/personal-site/



שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות