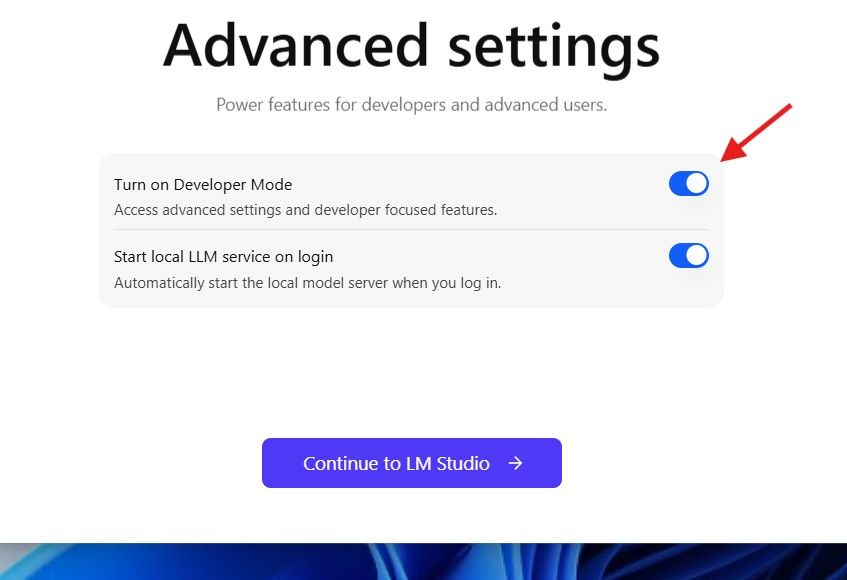
מחפש תוכנה נורמלית להרצה של מודלי AI אופליין
-
אשמח אם משהו יעשה לפה או ישתפ לי במייל E0556770172@GMAIL.COM
-
אשמח אם משהו יעשה לפה או ישתפ לי במייל E0556770172@GMAIL.COM
@הישבשר-המלומד
@שניאור-שמח כתב בחוקי הפורום:אין להעלות לפורום יישומים ותוכנות להרצת מודלי AI לסוגיהם השונים באופן מקומי, וכן לא לפרסם קישורים שלהם משירותי אחסון פרטיים כמו גוגל דרייב וכדומה.
ניתן לשתף קישורים הניתנים לשליטת הסינונים, כגון ל-Hugging Face, כך שקישורים שאינם מאושרים ייחסמו על ידי הסינון. -
 ב בני הבוט נעל נושא זה ב-

שלום! נראה שהשיחה הזו מעניינת אותך, אבל עדיין אין לך חשבון.
נמאס לכם לגלול בין אותם הפוסטים בכל ביקור? כשנרשמים לחשבון, תמיד תחזרו בדיוק למקום שבו הייתם קודם, ותוכלו לבחור לקבל התראות על תגובות חדשות (בין אם במייל, ובין אם בהתראת פוש). תוכלו גם לשמור סימניות ולפרגן ב-upvote לפוסטים כדי להביע הערכה לחברי קהילה אחרים.
בעזרת התרומה שלך, הפוסט הזה יכול להיות אפילו טוב יותר 💗
הרשמה התחברות